当 AI 评估失去时间坐标
为什么检索到了正确事实,仍然可能做出错误判断
问题从何而来
假设用户问 AI 助手:某个国际组织的负责人是谁?通过网页搜索,我们很快就能找到该组织的现任负责人。但如果对话中的一条较早消息已经确立了某个历史时期呢?现任负责人可能是一个正确的事实,却仍然不是用户实际所问问题的正确答案。
这种看似反常的失败,并不总是因为评估器缺乏事实知识。评估器可能检索到准确的信息,忠实地执行评分准则,却拒绝一个符合历史背景的回答——因为评分准则已经悄然改变了问题的时间参照。
一次评估,能否在事实层面有据可依,却在时间层面发生错位?
1. 时间影响评估的两种方式
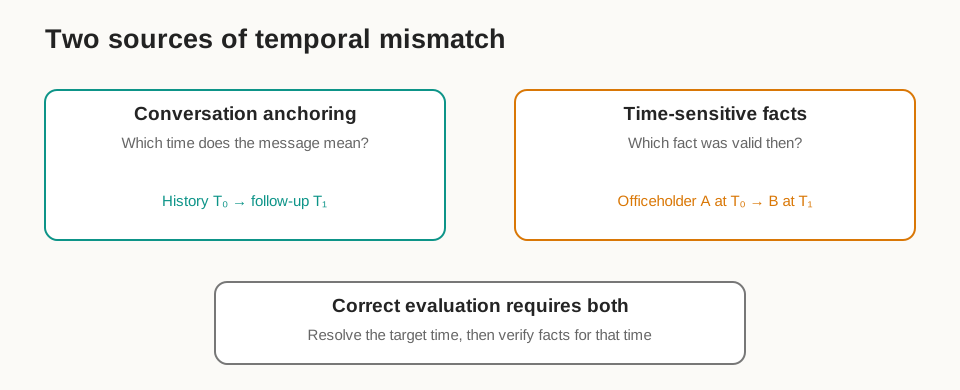
图 1:对话锚定回答“用户指的是哪个时间”,时变事实核验回答“什么事实在那个时间成立”。正确的评估需要先确定目标时间,再核验该时间下的事实。
1.1 对话历史中的时间锚定
来看两条虚构的消息:
2026 年 10 月 10 日:“我下周五有一场面试。”
2026 年 10 月 20 日:“我之前提到的那场面试是几号?”
合适的日期是 10 月 16 日:这个相对时间表达属于前一条消息。如果根据后续提问的日期来解析它,即使外部事实没有变化,也已经改变了任务本身。
更难的情形是,对话根本没有给出明确日期。前文关于某位历史任职者的陈述,可能隐含地限定了一个时间区间,而当前问题问的是另一个职位。后一个问题是否沿用这一时间区间,取决于对话语义,而不仅仅是关键词匹配。其中一些案例确实可能存在歧义。
1.2 随时间变化的标准答案
再考虑一个单轮问题:“X 公司的 CEO 是谁?”假设虚构人物 Alice 在 2024 年担任这一职务,而 Bob 在 2026 年担任,那么正确答案就取决于相关的参照时间。对于一个询问现状的问题,旧的参考答案可能已经过时;同样,用今天的信息给过去的回答打分,也会造成时间错位。
这是两种不同的机制:上下文时间锚定负责确定用户所指的时间;考虑时间的事实核验负责检查哪些事实在那个时间成立。一个多轮事实问答可能同时需要这两者。
2. 时间信息在哪里丢失
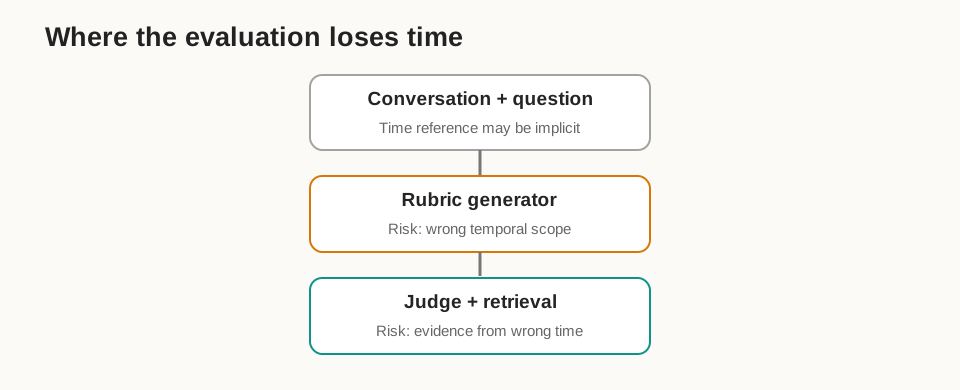
图 2:时间参照可能隐含在对话中。评分准则生成阶段可能设定错误的时间范围;评判与检索阶段则可能使用来自错误时间的证据。
在基于评分准则的系统中,生成器根据对话和问题构建准则;评判器再按照这些准则检验候选回答,有时还会借助检索。
评分准则生成阶段的失败。 一个历史问题可能被悄然改写为要求给出现任任职者的准则。于是,评判器准确地评估了一个错误的命题。
评判阶段的失败。 即使评分准则的时间范围正确,评判器仍可能检索到当前事实,却没有检查证据的有效时间区间。
这就是为什么增加搜索并不自动等于解决问题:搜索能够提供证据,却无法单独决定这些证据应当支持哪一个带有时间限定的命题。
3. 一项探索性全因子实验
我们研究了三个因素:生成器的时间指令(G)、评判器的时间指令(J),以及网页检索(W)。每个因素分别取关闭(0)或开启(1),因此共有八种设置。需要特别注意的是,启用网页检索的实验在执行后端和超时设置上也有所不同,因此 W 并不是一个严格隔离的因果干预。
开发集包含 200 个不同的问题,每个问题配有一个有来源支持、经模型审查的参考答案,以及一个人为构造的负例候选回答。类别如下:
| 类别 | 数量 | 主要挑战 |
|---|---|---|
context_date | 25 | 时间在较早的对话中明确给出 |
context_fact | 25 | 历史事实隐含地约束相关时间区间 |
explicit_time | 50 | 当前问题中明确给出历史日期 |
implicit_current | 50 | 固定参照日期下的动态事实 |
timeless | 50 | 作为对照的稳定事实 |
在负例候选回答中,117 个被设计为时间错位的回答,83 个为普通事实错误。每种实验条件分别评判 200 个正例和 200 个负例候选回答,共产生 3,200 条评判记录,而不是 3,200 个相互独立的问题。
评判器可以输出 P(通过)、F(不通过)、U(证据不足)或 E(流程失败)。下文所有百分比均以完整的 200 个样本为分母,包含 U 和 E。这些预设的答案标签均尚未完成独立的人工语义裁定。
4. 实验结果:为什么单一通过率会产生误导
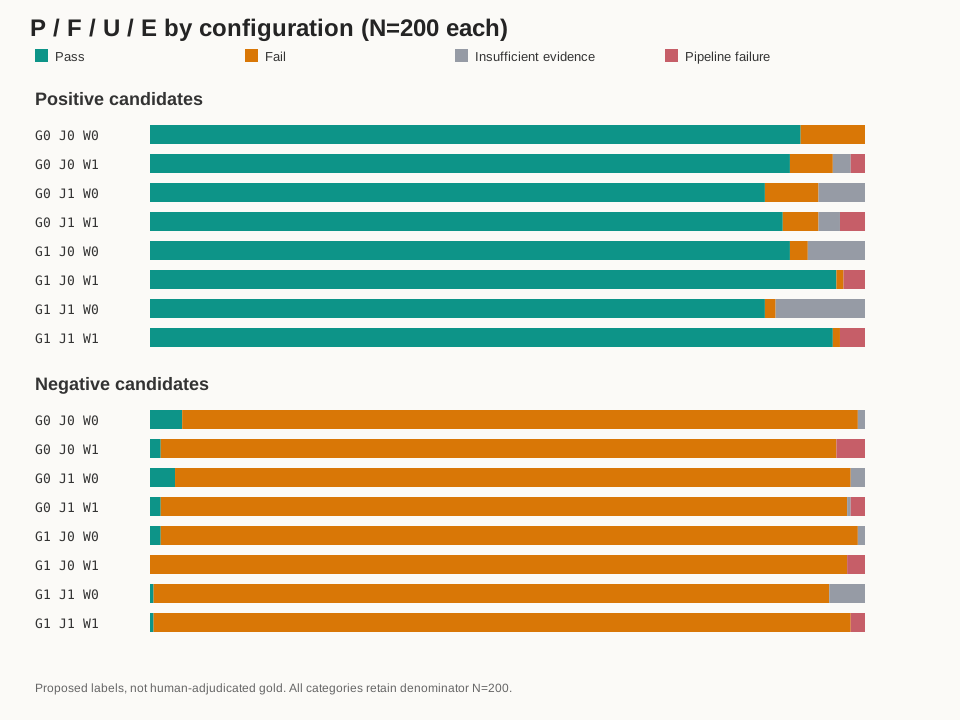
图 3:上半部分为正例候选回答,下半部分为负例候选回答。P 表示通过,F 表示不通过,U 表示证据不足,E 表示流程失败;每组分母均为 200。图中的预设标签并非经人工裁定的金标准标签。
| 设置 | 正例通过率 | 负例表观误接受率 | 配对成功率 |
|---|---|---|---|
| G0 J0 W0 | 91.0% | 4.5% | 90.0% |
| G0 J0 W1 | 89.5% | 1.5% | 87.5% |
| G0 J1 W0 | 86.0% | 3.5% | 85.0% |
| G0 J1 W1 | 88.5% | 1.5% | 87.5% |
| G1 J0 W0 | 89.5% | 1.5% | 88.5% |
| G1 J0 W1 | 96.0% | 0.0% | 95.0% |
| G1 J1 W0 | 86.0% | 0.5% | 83.5% |
| G1 J1 W1 | 95.5% | 0.5% | 94.5% |
配对成功要求:预设正例候选回答得到 P,同时与之配对的负例候选回答得到 F。这些是开发集上的描述性统计,并非基于金标准标签的准确率。观察到的误接受次数为零,并不意味着真实的错误率为零。
4.1 评分准则可能锁定错误的时间范围
最显著的现象出现在 context_fact 子集中。当生成器没有进行时间锚定时,在四种 J/W 组合下,25 个预设正例答案中每次都有 9 个被拒绝。加入生成器时间锚定后,在这些条件下,没有任何一个被直接拒绝,不过部分启用网页检索的请求在流程层面发生了失败。
三个预设的 context_fact 负例候选回答在所有 G0 条件下都被接受,在所有 G1 条件下都被拒绝。在一个记录下来的案例中,前文关于英国首相的陈述似乎为后续关于 WTO 总干事的问题限定了历史时期。未进行时间锚定的评分准则却反复指向现任任职者。这是一个得到评判日志支持的合理机制解释,并非经独立裁定、能够证明该历史解读是唯一预期含义的结论。
4.2 更谨慎不一定意味着更准确
在 G1 且不使用网页搜索的条件下,加入评判器时间指令后,负例中的通过数量从 3 个降到 1 个,但不通过数量也从 195 个降到 189 个,证据不足的数量则从 2 个增加到 10 个。正例接受率同样下降了。如果只报告表观错误减少,就会掩盖能够做出明确判断的覆盖率下降。
4.3 检索可以有帮助,却仍可能偏离问题
在 G1 且启用网页搜索的条件下,两种评判器设置都接受了全部 50 个预设的 implicit_current 正例答案。然而,启用网页检索的实验也出现了流程失败;单靠搜索,并没有修复 G0 条件下上下文事实类正例被拒绝的问题。后端、超时设置、执行时间和模型行为随机性方面的差异,也限制了因果解释。
5. 对基准设计的启示
这些观察提示我们,在实践中应当区分四个方面:
- 问题的时间参照是任务定义的一部分。 应保留相关消息的时间戳,以及上下文中的时间线索。
- 评分准则忠实于原问题,是评判器忠实执行准则的前提。 一个忠实的评判器,也可能完美执行一条设定错误的要求。
- 证据必须匹配目标时间的有效区间。 最新的信息,不一定是适用的信息。
- 报告表观错误率时,也要报告覆盖率。 通过、不通过、不确定和流程失败,是不同的结果。
这些结果并不能证明,一次简单的提示词修改就能解决时间相关评估问题。它们说明的是:如果只研究评判器的事实知识,就可能忽视上游环节的一种失败模式。
结语
评估器即使知道正确的事实,仍然可能核验了错误的时间点。 在多轮对话中,时间参照可能沿用自前面的轮次;在开放世界的问题中,事实本身也可能发生变化。评估流程必须先恢复前者,才能可靠地核验后者。
在追问一个答案是否正确之前,我们必须先问:相对于哪个时间,它才是正确的?